AI开源的下一个十年——乌镇大讲堂:把“大咖的盛会”变成“大家的盛会”
潮新闻 记者 朱承
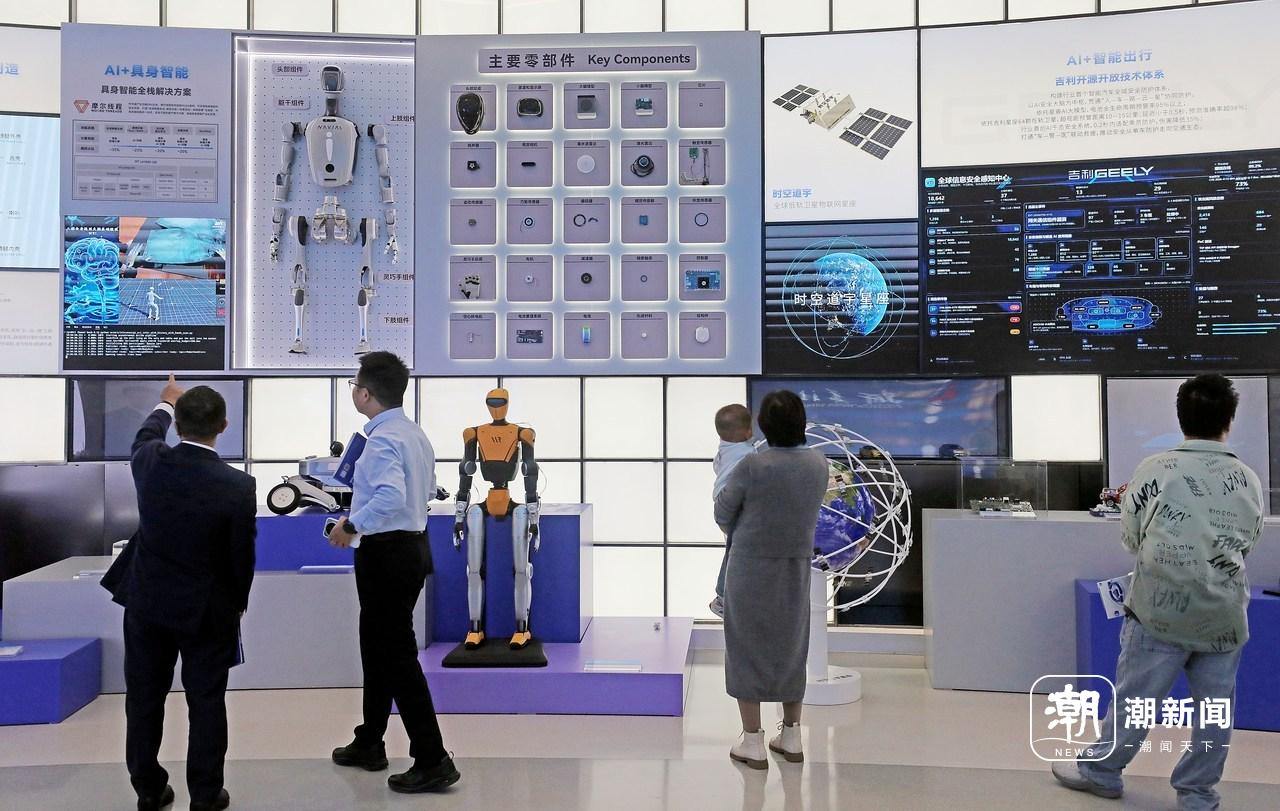
在乌镇世界互联网科技馆内,观众在参观开源主题生态体验馆。 记者 林云龙 李震宇 摄
11月4日下午,枕水而立的乌镇大剧院里,大讲堂正热闹开讲。窗外细雨绵绵,厅内座无虚席。
这是“乌镇大讲堂”首次面向社会公众推出。清华大学教授、阿里云高管、外文出版社主编先后登台,从技术、产业、人文三个视角,讲同一个题目:AI开源的下一个十年。
把峰会的一角办成一间向所有人敞开的教室,这件事本身就带着开源的意味——把“大咖的盛会”变成“大家的盛会”,把专业圈层里的议题,交给愿意坐下来听的年轻人。
让机器人互相学习
“如果闭源是一座精心修建的私家园林,只有一部分人能进去看,那么开源更像全人类共建的市政公园和高速公路。”清华大学电子工程系长聘教授、杭州市开源人工智能基金会理事长汪玉,用一个比喻开场。在他看来,没有开源,就没有今天互联网和移动互联网的快速发展。
然而,随着数字空间的基础设施已慢慢成形,他有了新的思考:数字世界那套东西,能不能直接搬给机器人用?
汪玉得出的答案是不能,原因有三。一是机器人的“脑子”还没定型:数字世界模型已到万亿级,具身智能才几十亿,而物理世界连续、不可预知,算法尚未收敛。二是机器人的“教材”不够:机器人要拿话筒、拧瓶盖、搬东西,得在真实世界里动手。三是算力不集中在一起:家里、工厂、每台机器上都有算力,是云边端协同,跟数字世界完全不一样。
怎么办?不是等一个万能模型从天而降,而是用开源开放的方式,给机器人重新搭一套“学校”:底层有开源本体当教具,开放传感器、执行器、灵巧操作;中间有训练平台把机器人管起来,把成功和失败的经验收上来、训练完再发下去;上面有开放的具身模型;两边有开放数据集和评测,看它到底能不能完成任务;最上面才是千行百业的应用。
这套“学校”里最有趣的是训练。
机器人出厂不一定会干某个特定任务,怎么让100个机器人快速学会?靠人遥操作教,人不够,培训也来不及。他们做了一个实验,进一步用96台真机互相学习,形成集体经验——哪台成功了、哪台失败了,经验可以启发其他机器人。只要扩大机器人规模,就能让它们快速学会能力。
这就是开源开放在物理世界的版本:不只是开放代码,而是让机器人之间互相学习、经验共享。
畅想未来,解决物理世界问题后,还可以把目光推到太空。如果地面上机器很强,算力也很强,而我们有很好的运载能力,那是不是可以把机器人送到月球上,帮我们建城?“因为我们还是要拓展人类的生存空间。至少要在技术层面,把这一类基础设施的能力摸透。”汪玉说。
把你的经验变成AI能调用的skill
今年4月,北邮附近一家叫金谷园的饺子馆,在GitHub上发布了自己的skill。
有人笑:一个煮饺子的,凑什么热闹?
阿里云智能集团副总裁、阿里云科技研究中心主任安筱鹏却说,嘲笑的人根本没理解这个行为的价值。
“这个skill不是给欧洲人看的,也不是给美国人看的,是给AI看的。”他给大家分享了一个理念——AI时代一个重要的认知转变:skill,也就是“技能”,正在成为AI时代的软件。
skill到底解决了什么问题?Anthropic两位专家的说法是:面对一份复杂的报税任务,你不需要一个智商300的数学家,你需要一个有20年经验的税务专家。而税务专家的经验,可以变成一种技能,被AI调用。
大模型学完了互联网上所有公开的知识,但它没学过律师怎么思考问题,也没学过你怎么写文章、怎么起标题、怎么搭结构。这类隐性的、属于你个人的知识,在互联网上学不到。
“但今天,你可以把它沉淀成skill,让AI去调用。”他打了个比方:skill就像孙悟空拔一根毫毛,一根毫毛能变出100个、1000个孙悟空。每个人除了拥有大模型,还需要把自己的经验、方法沉淀下来,用skill去帮更多人。
开源,正是让这件事跑起来的底层逻辑。
他举了两个例子,一个是爬珠峰。开源相当于派一架直升机,把你从地面送到海拔5200米的珠峰大本营;如果有一个强大的开源体系,那是有很多架直升机把你送到大本营——但从5200米到8800米,得你自己爬。开源降低创新门槛、提高效率、加速普惠。
另一个有关诺贝尔奖。2024年几位与AI相关的科学家获得诺贝尔化学奖和物理学奖,他们都把自己的方法开源出来,让它成为下一轮竞赛的公共基线。这就是“竞赛—开源—创新”的循环。
放进更长的历史看,从文字到印刷术到AI,人类文明就是一部知识压缩与转化的历史,一部压缩效率不断进化的历史。在安筱鹏看来,skill只是走到了一个新的阶段。它的逻辑,本质上是一次知识层面的开源。
人要去做尚未被定义的事
一句18个单词的译文,被ChatGPT改了7处。人机之间,谁更懂表达?
外文出版社荣誉英文主编、中国政府友谊奖获得者大卫·弗格森第三个登台讲课,他先讲了一件小事。
一位同事把他改过的一句译文拿去问ChatGPT,开启了一场人机翻译能力的小比赛。他一句一句比对,最后表示:7处里只有1处比他的好——“scars”比“wounds”好,因为更有画面感。其余6处,都不如他。
“这是我第一次真正被迫去思考:AI 在翻译中到底扮演什么角色。”大卫·弗格森发现,大语言模型从互联网的海量文本里学习,而写作、翻译、编辑呈现出一种“钟形曲线”现象:极少数人做得极好,绝大多数人水平平平。也就是说,AI能从“优秀”人群里采到的样本很少,能从“平庸”人群里采到的样本却极多。“于是大语言模型得出结论:平庸就是好的,因为平庸的样本最多。”所以ChatGPT犯的错,恰恰是他预期一个平庸译者会犯的错;ChatGPT认为漂亮的表达,恰恰是他眼里平庸的表达。
一个问题随之浮出来:AI到底强在哪里、弱在哪里?人又该做什么?他的判断是,AI在“有对有错”的领域极强,比如STEM学科、答案明确的法律流程;但在需要判断、需要主观性的地方,它吃力得多。AI的判断来自它吃进去的样本。开源开放不只是开放模型,也关乎数据、语境和判断的来源。
“那么,译者、口译员的未来在哪?”一位观众提问。
他的回答出其不意:讲故事。
他说,译者太宝贵了,不该被浪费在给AI改错上。翻译这个行当的工作方式,一定会变。以他60年的经验,也因为他自己会说四门语言——语言好的人往往文字也好,这意味着他们是好的讲故事的人。
当AI把“平庸”变得唾手可得,人更要去做那些尚未被定义、却至关重要的事。他说,未来,不是“你怎样才能更好地去配合AI工作”,而是“你怎样才能成为一个目前还不真正存在、但至关重要的行业的一部分”。
“转载请注明出处”
责任编辑:王晶