观智潮|代码之外,FDE的开源实践和乌镇那座“摸得到”的体验馆
潮新闻 记者 张云山 见习记者 郭文青
水乡的雾气还未散去,乌镇世界互联网科技馆内已是一片涌动的数字热浪。
11月1日,2026年世界互联网大会乌镇峰会·开源主题生态体验馆将正式拉开帷幕。这座体验馆集中首秀人工智能开源开放重大科技成果与国家人工智能应用中试基地成果。一楼核心展区设两大主题特展与互动体验区,展示021科学基础模型、魔搭模型开源社区、吉利全域安全技术体系等标志性成果;二楼影像展区用光影定格时代步履;三楼的“开源会客厅”里,青年科创者们可以在此交锋。
在乌镇世界互联网科技馆里,真正值得琢磨的,不是“开源长什么样”,而是开源落到谁的手里、改变了什么。将目光从展厅移向真实的产业腹地,这场以“开源开放 共建共享”为内核的变革,正以极其务实的姿态,重塑着人、企业、资金和规则的边界。
AI时代的开源开放,把过去需要一支团队才能凑齐的技术栈,拆成了超级个体能调用的模块。然而,当代码的壁垒被推倒,合规、安全与信任的断层却更加刺眼。开源不是免费午餐,更不等于无主与无治理。在这场从“代码共享”迈向“产业共生”的变革中,技术只是序章,规则的重塑与信任的共建,才是真正的底牌。
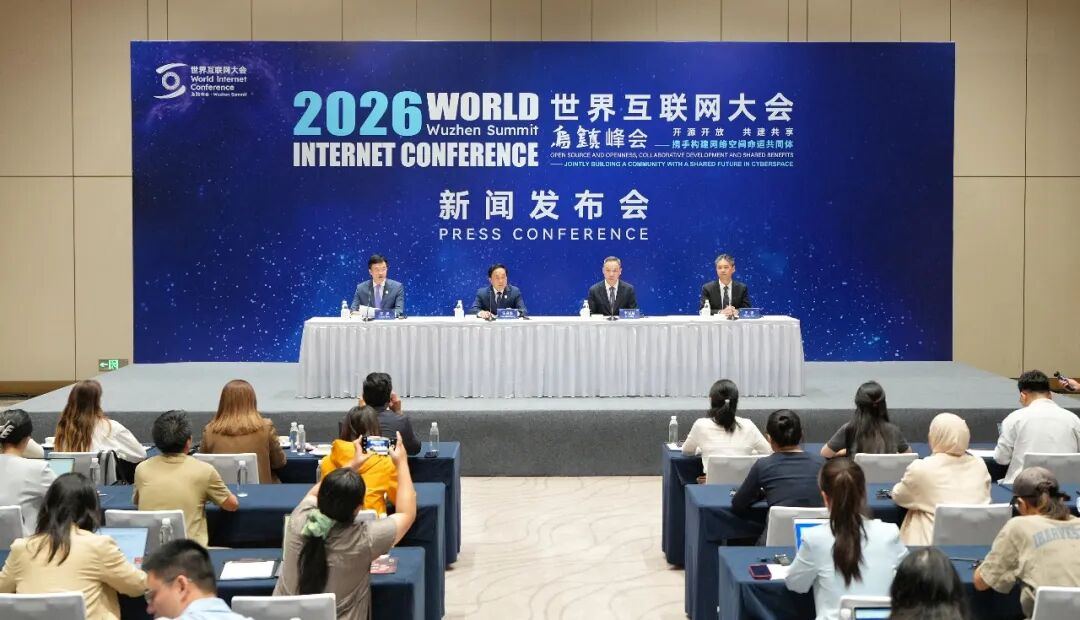
乌镇峰会新闻发布会 图源:世界互联网大会官网
DeepSeek登顶,浙产开源模型成全世界的开发者台阶
在OpenRouter最新一周AI大模型调用量周榜(10月19日至25日)上,榜首为DeepSeek于10月17日更新的V4.1-Flash-1017版本,单周调用量达33.6万亿Token,环比增幅801%。近期DeepSeek动作不断:10月20日官宣开源自研推理框架DeepInfer,10月22日又传出拟筹集约1000亿元融资的消息。
榜单第二名是DeepSeek旧版V4.1 Flash,第三名归属MiniMax M3.1 Flash。前十其余席位还包括智谱AI GLM 5.3 Flash、腾讯Hy4 preview,以及OpenAI、Anthropic、英伟达的海外模型。
拉长到近一个月看,市场格局变化更加突出。一个月前,海外闭源模型占据榜单前排更多席位,国产模型席位相对分散;近三十天里,国产厂商持续高频推送迭代版本,多个Flash新品接连冲进前十,逐步挤压海外模型的前排位置。
千问(Qwen)走的是另一条路,却殊途同归。截至2026年,阿里累计开源超460个Qwen模型,衍生模型超30万个;Qwen在Hugging Face全球累计下载量突破30亿次。更值得留意的是许可证选择:在178个参数量超200亿的中国开源模型中,59%采用Apache 2.0,22%采用MIT,无一限制商业使用。
两个浙产模型放在一起看,图景更清楚:Hugging Face 2026年春季报告显示,中国自研开源模型下载占比达41%,首次超过美国,成为该平台规模第一的开源模型供给方。
这些数字落到地面,是什么样子?在东南亚,语言多达1200余种,西方模型预训练数据里标准英语占八成以上,东南亚语种内容一度只有0.5%;而千问大模型在预训练阶段就覆盖当地上百种语言。在非洲,开发者用DeepSeek、Qwen做底座,拿自己的数据做定制化服务,而不是等某家巨头来“适配”他们。
浙江大学求是特聘教授陈为说,开源把过去只有少数人买得起的东西,变成所有人抬脚就能上的台阶。一个县城的小公司和一个巨头,拿到的是同一套起跑线上的工具。
今天,DeepSeek和千问正在把同一件事放大到全球尺度——把台阶“修”到非洲开发者的电脑前,“修”到东南亚小语种使用者的手机里,“修”到硅谷创业公司的服务器上。
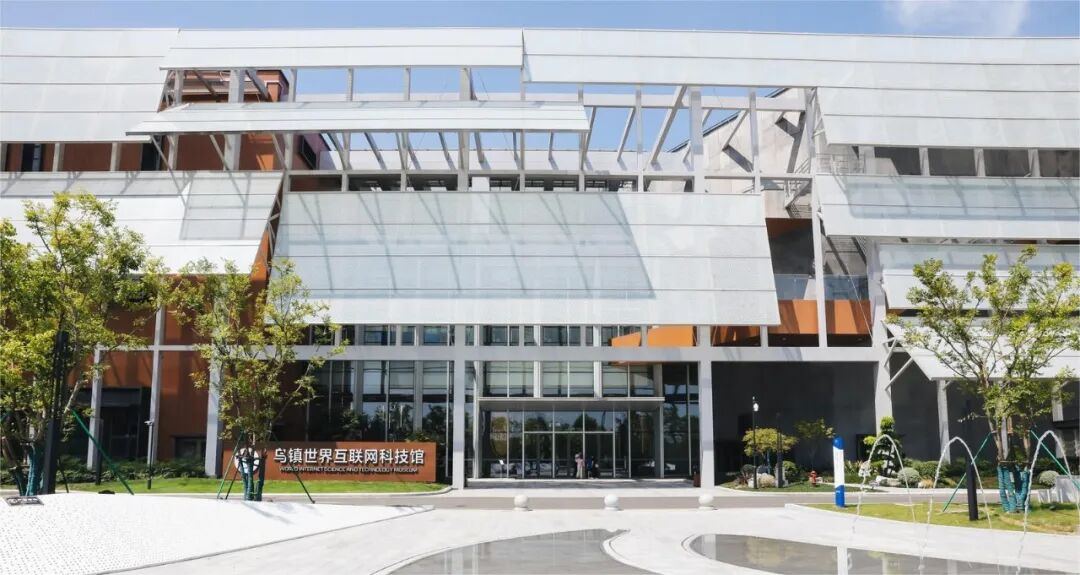
乌镇世界互联网科技馆 图源:世界互联网大会官网
车间里的“超级个体”,先得是“会用开源的人”
展馆里展示的模型虽已开源,但真正的考场在工厂的车间。从“下载”到“用进业务”,中间还隔着一公里长的交付链路。
本届乌镇峰会首次把“一人公司”(OPC)系统性地推到台前。“人工智能OPC嘉年华”打造“五个一”体系,核心逻辑很朴素:你有场景,OPC有方案。承接这些方案的,是正在批量走向车间的FDE,也就是前线部署工程师。
元贞数字科技创始人兼CTO陈榆,常说自己干的事是“把技术钉进现场”。他是谷歌人工智能/云技术专家、AMD中文教程核心作者,也是开源项目llm-self的核心作者,主要做端侧Agent系统设计与开发,服务制造业和交管领域。
制造业对“AI落地”有过太多教训。某中型注塑厂曾花200多万元上AI排程系统,上线后却彻底失效——ERP里一个零件有3个编码,设备产能数据是3年前的,工人根本没法用。根子不在模型不够聪明,而在“做AI的不懂工厂,做工厂的不懂AI”。陈榆做的电力图纸配单Agent,要理解图纸背后的物料逻辑;图像类文档智能审核Agent,要嵌入企业真实的审批流。
开源在这里帮了什么?陈榆说得很实在:没有开源模型和开源工具链,要多花好几倍时间和精力,项目大概率还会失败。他们用了开源的OCR模型、Agent框架和LLM模型,用开源项目快速搭出可运行的全链路Demo,技术方案行不行很快就能验证,风险降下来,后续也可控。
“AI不是替代人,而是把人从重复、枯燥的工作里解脱出来,让人能做更多人性化关怀的事。”陈榆说,工具只是载体,重要的是对整个系统的设计思想。
通向惊喜创始人张晨曦是一位极客,他主要做自主智能体网络与RSI研究,自研Flowness,服务上市公司及多家年营收数亿元企业;还拿过真格基金JEV黑客松冠军、环球黑客松铜奖。他也是开源的受益者,每天大约60%的时间在写代码,开发自己的Agent系统——每工作1小时,背后有100个Agent小时。
张晨曦对开源很冷静:开源确实降低技术成本,但只有在很完善的生态里才成立。有些开源项目漏洞多,和业务适配也不强,除非80%以上吻合,否则理解和学习成本高于它省下的成本。他的判断标准很简单:别人的架构比你更优化、更优雅、更简单、更稳固,一定用开源;没有,就按自己的纪律开发。
谢尧之前在互联网大厂工作,今年选择了自主创业,他也是Datawhale FDE100成员。他的第一个单子,是给制造业老板做经营驾驶舱,2个人3周交付;如果不让用开源,他跟做软件外包的朋友算过,大概需要4个人、2个月起步,折合人月约1.5对8,效率相差5倍多。他说得很坦诚:“没有开源生态,我很难做这一行。”
但他也发现,开源只是入场券——开源省的主要是基础层:模型能力不用自己训练、数据库和中间件不用自己开发、前后端框架不用从零搭;可怎么在客户生态里运行,非常依赖行业理解、客户数据梳理和ERP系统测试。他写代码大概占30%到40%的时间,跟客户沟通需求、梳理遗留系统和旧数据则占50%以上。门槛依然在:行业理解、客户资源、沟通和项目管理。
从下载模型到用进业务,最大的断点在于“业务语境下的不确定性没有被标准化”:公开评测集是干净的,真实业务输入却充满脏数据,权责与信任的断层因此更难跨越。
开源社区Datawhale创始人范晶晶给FDE定了十五个字:“懂业务、会用模型、守安全、对结果负责。”开源把技术门槛拉低了,却把工程化、合规化和信任建立的门槛挪到了FDE肩上。超级个体不是“一个人什么都能干”,而是“一个人站在开源底座上,把一公里长的交付链路跑通”。
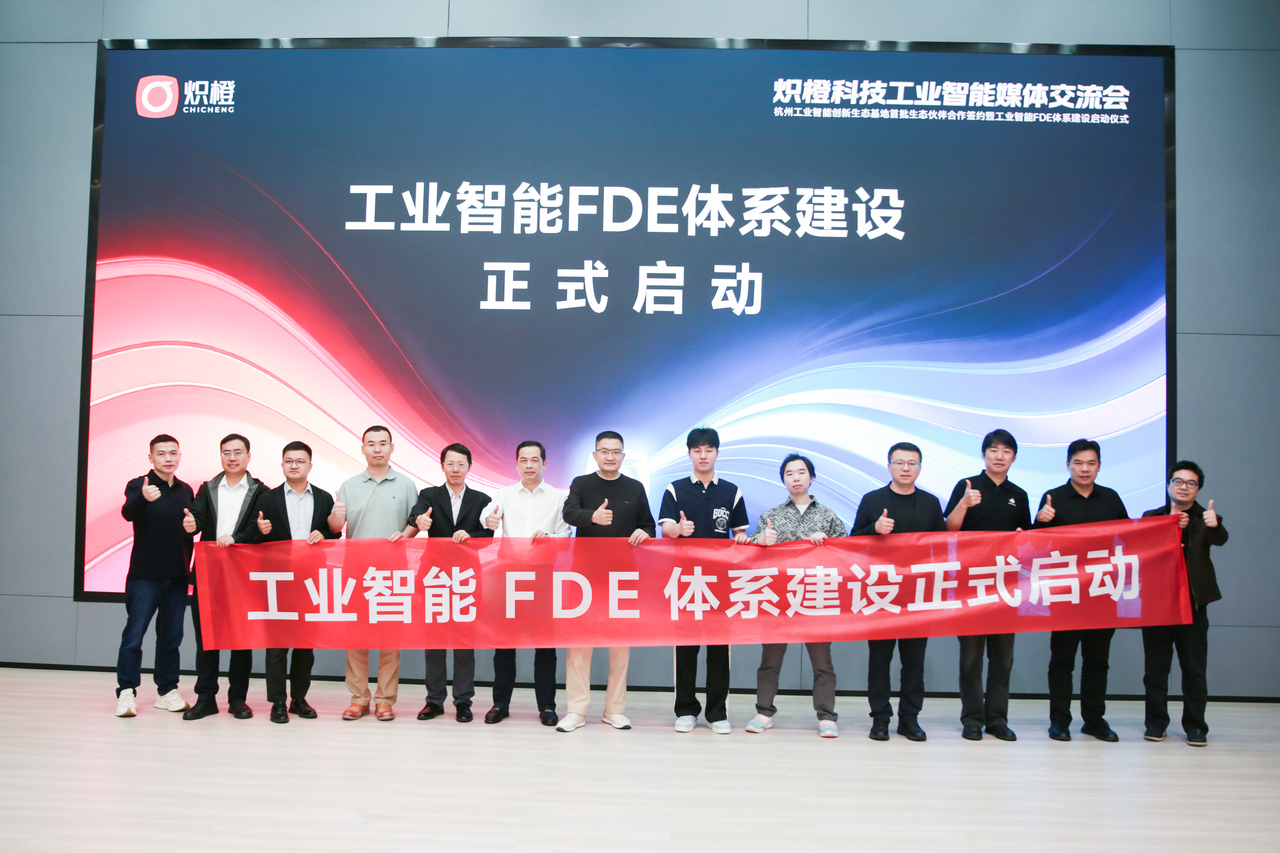
工业智能FDE体系建设正式启动 图据潮新闻
浙江这片“数字雨林”,不是一天长成的
这些车间里的实践并非孤立火花。在浙江,开源生态已如同一片“数字雨林”,长成一条从模型层到工厂层、再到交付层的完整链条。
土壤是模型层的普惠底座。截至2026年10月,魔搭社区(ModelScope)已服务全球超3300万开发者,汇聚超27万个开源模型,DeepSeek、智谱、MiniMax、阶跃星辰、KIMI等头部模型均在此开源。魔搭发起人周靖人的定位很直接:让模型成为千行百业创新的“水电煤”。浙江省“十五五”规划已明确支持魔搭建设国际领先的人工智能开源社区。
工业层走的是一条更重、更慢的路。蓝卓科技的OpensupOS成为国内首个开源工业AI数据底座,服务超11000家工业企业。桐昆集团孵化的恒云智联,正在做首个化纤行业全面适配开源鸿蒙的国产化工业操作系统纤开鸿OS。
场景交付层,炽橙科技扮演“连接器”。炽橙联合传播大脑、Datawhale等生态伙伴启动工业智能FDE体系建设,将AIDT工业智能体开放平台的工具和案例模板对外开放,让懂工艺、懂产线的企业人员基于真实数据快速搭建专属智能体。
技术平权在浙江的版本,最终落在产业平权。魔搭做普惠、蓝卓做底座、恒云做行业发行版、炽橙和元贞做交付——四层咬合,才构成从“模型可用”到“产线可跑”的完整链条。
浙江大学求是特聘教授陈为把开源的好处分成三层。第一层是接入平权,成本降下来,用得上。第二层是能力平权,这是开源最被低估的价值——全世界最好的代码就摊在那里,任何一个学生、任何一个西部县城的工程师,都可以直接读到工业级的实现,开源是最便宜的教育资源。第三层是参与平权,从使用者变成贡献者,从“用别人的规则”到“一起定规则”,这一步才是真正的分水岭。
热闹背后,AI开源还需要划分好边界
开源跟闭源是AI永恒的路线之争。
炽橙科技首席产品官孙发亮直言,工业场景容错率极低,工业开源绝不能照搬互联网消费领域玩法,现实中有四大瓶颈:供应链安全风险——大量工业软件栈依赖海外开源组件,上游漏洞会沿依赖链直接传导至产线;知识产权与许可证风险——不同许可证存在“传染性”,工厂的工艺Know-How一旦盲目开源将流失核心竞争力;可靠性短板——社区版本和可上线工业版本之间存在巨大工程化鸿沟;商业化难题——很多项目靠少数企业维护,容易出现“无人维护”。
陈榆在工厂也感受到这种谨慎。制造业客户对开源普遍持怀疑态度,在核心组件上倾向于有人修复的商业软件;对稳定性要求不高的部分则会选择开源组件,降低成本和减少对单一厂商的依赖。
开源不是免费午餐。上半场比的是谁能把模型和工具开放出来,下半场比的是谁能在开放的同时,把许可证边界、数据合规、供应链安全和责任归属管住。
“工具底座、开发模板可以开放共享,但是工厂沉淀的本体图谱、工艺参数、故障知识,属于企业私有资产,应当做好隔离。开源的核心是协同创新,不是不加区分地把一切拿出来共享。”孙发亮表示。
未来怎么走?炽橙科技给出的路径是分层开放:底层基础组件开源,平台工具向产业开放,企业核心工艺私有化保护;从“代码开源”升级为“产业知识开源”,把行业案例、实训体系、FDE人才培养纳入开源生态;建立工业开源治理体系,平衡开放创新与风险管控。
生态协同大于单一项目开源,大模型企业、装备厂商、算力硬件、开源社区、FDE人才咬合在一起,才能以生态力量破解单点技术落地难题。
Datawhale开源项目负责人谢文睿,更愿意把这批以交付为生的FDE人才看作开源生态中有潜力的新建设者,他们把开源带进真实生产环境,也有机会把问题带回社区。这种贡献未必首先表现为代码,却可能帮开源项目发现最需要改进的地方。
这也回答了另一层问题:FDE靠开源赚钱无可厚非,但关键在交付之后有没有东西回到公共积累里——一个可复现的问题反馈、一项通用功能的修复、一份别人能照着做的文档。商业成功不会自动转化为对开源的支持,“用开源”和“养开源”,要能在同一个人身上发生。
台阶修平之后,还得有人守边界
乌镇那座体验馆有一个容易被忽略的设计:依托“365天永不落幕”的运营机制,三楼的“开源会客厅”峰会之后还会承接“开源青年说”与“科创之夜”,让展陈沉淀为可流动、可复制的公共资源,而不只是一年热闹一次。
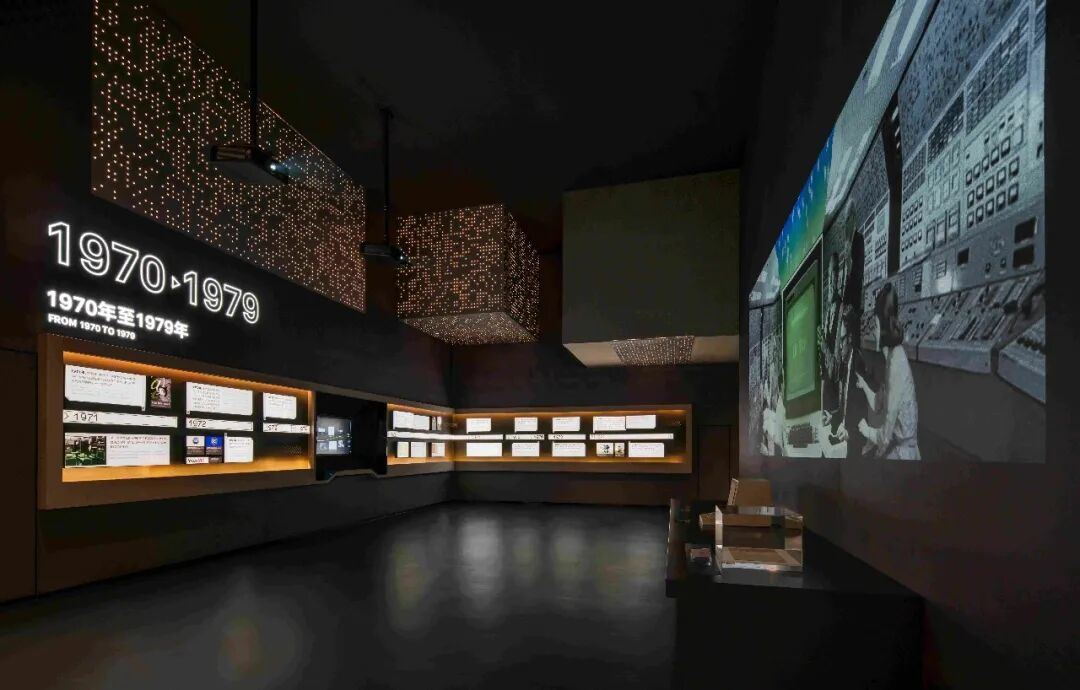
乌镇峰会·开源主题生态体验馆 图源:世界互联网大会官网
一楼摸着屏幕看模型系谱的观众、车间里调试系统的工程师、深夜在魔搭上调数据集的独立开发者,处在同一个生态的不同位置上。开源正在从“代码共享”走向“产业共生”,但共生的前提不是无条件的给予,而是一套需要被持续维护的协作规则:有人开放底座,有人填平断裂,有人守住边界。
浙江大学求是特聘教授、本科生院院长吴飞认为,人工智能是技术属性与社会属性相互融合的技术;开源所共享的能力,让每个人都能在新的高度上开展创新。开源生态的健康发展与“用开源”之间是协同的——更好的使用,一定会促进更高水平的开源。
乌镇峰会今年把主题定为“开源开放 共建共享”,抓住了核心——在数字世界里,共建共享最成熟的一种制度安排,就是开源。开源不等于无主,更不等于无治理,它是共治。代码可以fork,但信任不能fork。
当我们在乌镇体验馆的灯光下谈论未来,谈论的不仅是技术共享,更是规则重塑与信任共建。陈为那句话,值得再听一遍:门槛不是被“让”出去的,是被“修平”了。台阶修平之后,还得有人扶着栏杆、守着边界,让更多人敢走、能走、走得远。
“转载请注明出处”
责任编辑:周夏林