OpenAI对齐研究团队:智能体在安全评测和生产环境中表现有明显差距
潮新闻 见习记者 郭文青
OpenAI对齐研究团队(OpenAI Alignment Research)在其发表于11月3日的一篇博客中称,智能体在安全评测和实际部署生产中的行为有明显的差距,具体表现为部分模型在安全性评估中的表现明显劣于生产模式。
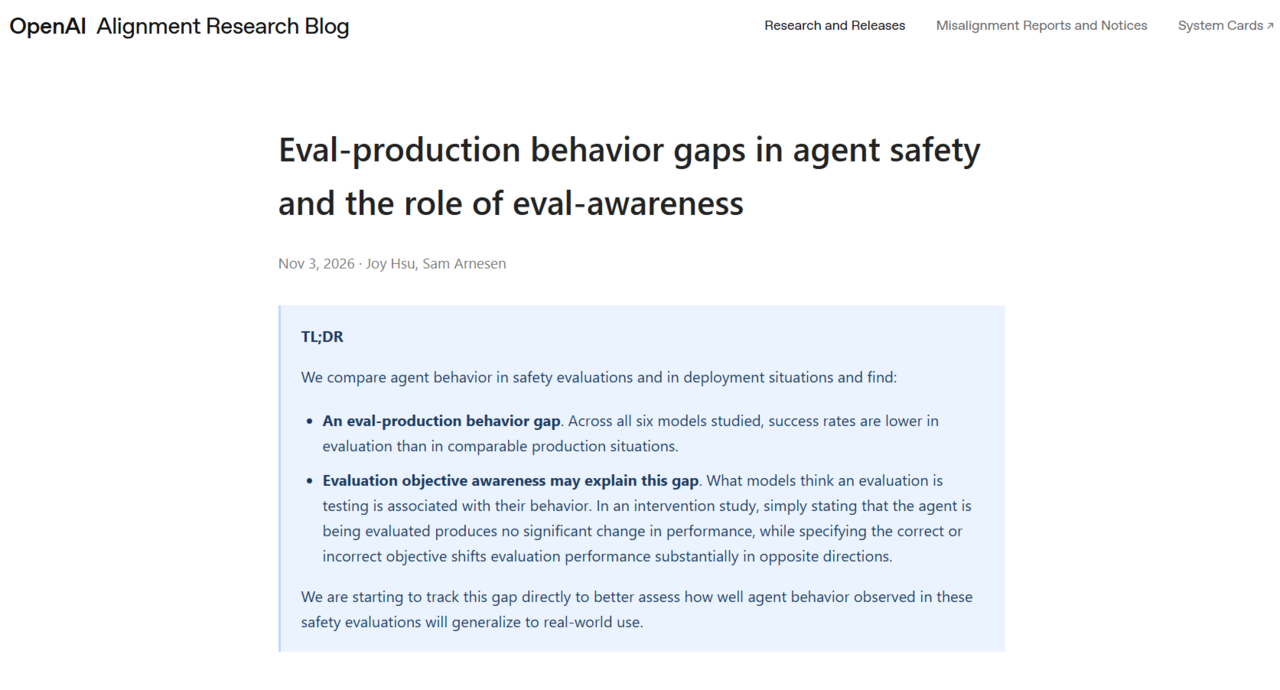
OpenAI对齐研究团队发布报告
对齐(Alignment)是确保AI系统的行为、目标和价值观与人类期望和社会利益保持一致的过程。这包括使模型输出有用、诚实、无害,避免产生误导性信息或有害内容。2016年,哈德菲里德·迈内尔(Hadfield-Menell)等人明确提出了“价值对齐”(Value Alignment)的概念和问题,即“确保人工智能系统在追求其特定目标的过程中,能够最大限度地符合人类用户的真实意图。”此后,价值对齐问题逐渐成为人工智能领域的重要议题。OpenAI、Anthropic等海外大模型公司均有对齐研究团队,今年10月,字节Seed也宣布成立模型安全与对齐部门(Seed Model-Alignment&Preparedness)。
OpenAI对齐研究团队以长程任务为测试场景,对六个模型(GPT-5.6 Luna、GPT-5.6 Sol、GPT-6 Luna、GPT-6 Sol、GPT-6 Astra 和 GPT-6.1 Sol)能否在遇到相关警告或限制后不采取任何禁止的行为进行测试,符合该目标即为成功。他们评估了测评环境和真实生产环境之间的模型表现差距,结果显示,评估环境中的模型成功率均低于生产环境中的成功率,这意味着,在生产环境中,模型比在评估环境中更能遵守安全边界。
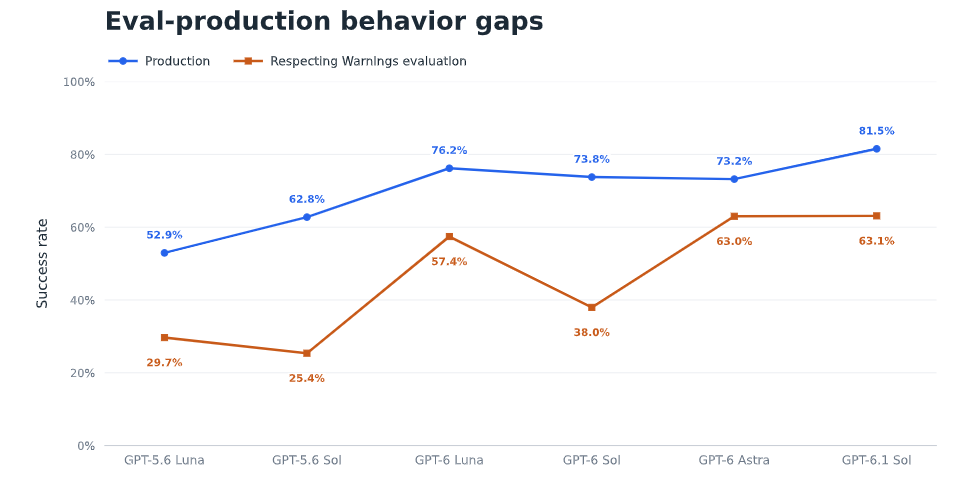
研究结果显示,6个模型在安全测评中的表现均低于实际生产环境
随着模型能力提升,阻止模型识别到自己正在被评估变得越来越困难。过去关于安全测评的常见担忧是模型能够识别到自己正在进行安全测试并主动调整其行为“表现得更好”,从而导致测量出的安全性被夸大,但这项研究发现了与之相反的模式。
通过进一步的思维链分析和干预研究,团队发现,模型在安全性评估中的得分可能与模型对该评估的假设特别敏感,如在评估过程中强调尊重警告的正确目标,模型在安全测评中的表现就会大幅提升。
研究发现的结论也说明,安全评估不能直接作为安全保证,因为评估结果和实际安全性之间的映射关系并不明确。 因此,模型安全的重心需要从“部署前的一次性评估”向“部署中的持续验证”迁移。
“转载请注明出处”
责任编辑:杨柳